


對於今天才剛看到這項 AI 相關研究、因此陷入恐慌的大批社群媒體用戶來說,這幾乎意味著我們所熟知的網路匿名時代已走到終點。
這篇今天再度在 X 與 Reddit 上瘋傳的研究論文,其實出自今年 2 月的一項研究;而其核心發現正讓各地網路匿名使用者不寒而慄:AI 可以從一個匿名帳號,推斷出你在現實世界中的真實身分。
這篇論文題為「利用大型語言模型進行大規模線上去匿名化」(Large-scale online deanonymization with LLMs),作者來自 ETH Zurich、AI 安全組織 MATS,以及 Anthropic 研究員 Nicholas Carlini。Anthropic 正是 Claude 背後的公司。
研究人員聲稱,大型語言模型——也就是 Claude、ChatGPT 與 Gemini 背後的 AI 系統——可以閱讀某人的匿名貼文,進而推斷出其現實身分。這不是靠駭客手法,而只是透過閱讀、搜尋與推理;也就是這些聊天機器人每天早已在無數日常任務中執行的同類能力。
研究人員打造出一個 AI,能在不到一分鐘內、花 2 美元就起底任何「匿名」Reddit 帳號。
ETH Zurich 和 Anthropic 發表了一篇令人不寒而慄的論文,證明網路上的「實用匿名性」已正式死亡。
他們建立了一條全自動化的 AI 流程,能夠接收你的…… pic.twitter.com/XMeXifhDf3
— Superman (@thesupermannx) 2026 年 9 月 23 日
論文寫道:「我們的研究結果顯示,過去保護網路上化名使用者的『實用模糊性』已不復存在,線上隱私的威脅模型需要重新檢視。」
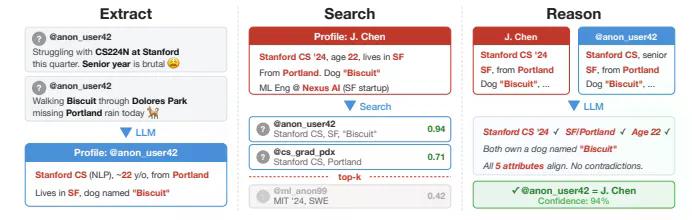
研究人員將這種攻擊拆分為四個步驟,分別稱為 Extract、Search、Reason 與 Calibrate。
「Extract」指的是將某人的貼文餵給 AI,讓它整理出此人的概況:可能住在哪裡、從事什麼工作、有什麼興趣,甚至包括英式拼字這種小習慣,或某次隨口提到的狗名字。
「Search」則是把這份摘要轉換成嵌入向量,也就是一串可讓電腦在數千名候選人中,迅速找出相似個人檔案的數值表示。
「Reason」是由更強大的模型檢視最有可能的幾個匹配結果,進一步推理哪一個才真正吻合,並像人類調查員一樣交叉核對各種細節,只是速度快得多。
「Calibrate」則是讓 AI 為自己的判斷信心評分,因此它只會在相當有把握時才做出猜測,否則就保持沉默。
在一項測試中,團隊蒐集了 338 名以化名為主的 Hacker News 討論板用戶,這些人曾在個人簡介中附上 LinkedIn 檔案連結。研究人員先移除所有可識別資訊,再要求一個 AI 代理僅憑網路搜尋來判斷他們是誰。結果 AI 正確辨識出其中 226 人,命中率為 67%;而在它實際做出的猜測中,約每 10 次會錯 1 次。
在另一項測試中,研究人員使用 Anthropic 自家對 125 名科學家所做訪談研究的逐字稿,AI 只根據這些人描述自身工作的方式,就成功辨識出至少 9 人。
真正關鍵的發現其實是成本。根據論文,執行一次這類搜尋,AI 訂閱費成本只需 1 到 4 美元。
而且這不需要資料外洩、駭入或內部權限。它使用的只是一般聊天機器人內建的網路搜尋與摘要能力。研究人員認為,這正是它難以防堵的原因:並不存在一個可被直接關閉的「把這個人去匿名化」按鈕,而只是一連串各自看似無害的任務。
這並不是人們第一次因為幾個零碎細節就被揭露身分。早在 2008 年,研究人員就曾透過與公開 IMDb 評論進行比對,破解 Netflix 所謂匿名的電影評分資料集。如今不同的是,AI 能夠在雜亂、非結構化的文字中進行這種匹配——像是笑話、留言、評論、隨口提及的內容——而不是在整齊的試算表裡,而且它能自行完成這一切。
論文中那些聽起來最嚇人的數字,其實附帶一個值得注意的前提。為了衡量成功率,研究人員需要事先知道受試者的真實身分,因此他們挑選的是本來就已連結 LinkedIn 的帳號,或者把同一個人的發文歷史切成兩半,再隱藏兩者之間的關聯。
這是一種受控的最佳情境設計,並不能證明今天任何隨機的化名帳號都能被破解。
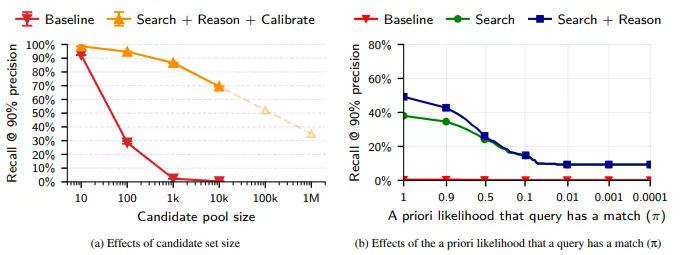
規模同樣會削弱研究中那些最駭人的數字。候選人池越大,要從乾草堆裡找出那根針就越難。在 8.9 萬名候選人的資料池中,即便最強的 AI 方法,在 90% 精確率下,仍只能找出大約一半的正確匹配。所謂 precision,是指它做出的猜測有多常是正確的;recall,則是指它實際抓到了多少真實匹配。
研究人員也沒有公開他們的工具、提示詞,或任何被挖出的真實姓名,而且研究在發布前已通過倫理審查委員會。他們不是在發放一套人肉搜索工具包,而是在記錄一種作者認為現有 AI 模型本來就已具備的能力,不論這篇論文是否存在都一樣。
即使你從未在 Reddit 發文,這件事為何仍然重要
加密貨幣使用者對這種恐懼早已不陌生。2025 年 Coinbase 資料外洩事件之後,接連發生的人肉搜索與綁架未遂浪潮——以及其他許多案例——已顯示,一旦身分資訊外洩,如何迅速演變成有人出現在你家門口的真實地址風險。
AI 驅動的去匿名化,本質上是同樣的威脅,只是把「資料外洩」這一步拿掉:它利用的是你早已公開發布的內容,不需要任何外流。
這項研究發布的幾個月前,Anthropic 才披露,受國家支持的駭客曾利用 Claude 幾乎獨立執行一整場網路間諜行動。這再次提醒人們,關於 AI 濫用的研究進展,持續跑在那些原本用來約束它的安全護欄之前。
對於那些因為社會運動、受虐經歷、性傾向、移民身分,或工作環境不鼓勵公開表態,而選擇以化名發聲的人來說,這意味著:多年來散落在舊留言中的家鄉、雇主,甚至寵物名字,都可能累積成一枚可識別的指紋。這種事過去並非不可能——只是 AI 讓它變得更快、也更便宜。
但如果你真的擔心這類人肉搜索風險,解法不是恐慌,而是習慣:盡量不要把過多具體、可識別的細節綁定在同一個化名之下;而對於真正敏感的內容,則應使用那些從設計上就不保留你資料的工具。
 COIN







