


Anthropic روز سهشنبه Claude Opus 5.5 را منتشر کرد؛ نخستین مدل از چیزی که این شرکت آن را خانواده Claude 5.5 مینامد. Anthropic میگوید این مدل جدید در بیشتر وظایف در سطح Claude Fable 5.1، گرانترین مدل پرچمدارش، عمل میکند.
اما نکته جالب اینجاست که هزینه اجرای این مدل ۲۰٪ کمتر از Opus 5، یعنی مدلی که جایگزین آن شده، است و همچنین ۶۰٪ ارزانتر از Fable 5.1، پیشرفتهترین محصول این شرکت، تمام میشود.
آنطور که پیداست، این مدل بسیار توانمند است. این پیشرفتهترین مدل هم از نظر نسخه (۵.۵ در برابر ۵.۱ Fable) و هم از نظر خانواده است (Opus بزرگترین مدل عمومی در دسترس است، پس از آن Sonnet قرار میگیرد و Haiku کوچکترین مدل این مجموعه است).
Anthropic میپذیرد که فاصله میان Fable و Opus کمتر از چیزی است که بنچمارکها نشان میدهند، اما عمومی بودن این مدل در پلنها و ارزانتر بودن آن به ازای هر توکن، آن را برای بیشتر کاربران Claude به انتخابی بدیهی تبدیل میکند.
Opus 5 در ماه ژوئیه عرضه شد و با قیمت پایینتر و امتیازهای بهتر در اکثر بنچمارکها از Fable 5 پیش افتاد، اما Fable 5.1 در اوایل سپتامبر از راه رسید و ورق را برگرداند؛ بهطوریکه در تمام بنچمارکهایی که Anthropic منتشر کرد، Opus 5 را شکست داد.
Opus 5.5 بار دیگر این فاصله را کم میکند، این بار نه در امتیاز خام بلکه در قیمت. Lovable، یک پلتفرم توسعهدهندگان که در ژوئیه Opus 5 را با آزمونهای کدنویسی داخلی خود ارزیابی کرده بود، در بیانیهای که Anthropic منتشر کرد گفت مدل قبلی «پایدارتر بود و نوسان بسیار کمتری از یک اجرا تا اجرای دیگر داشت»؛ همان استدلال مبتنی بر بهرهوری که Anthropic اکنون دوباره مطرح میکند.
Opus 5.5 همچنین نخستین مدلی است که Anthropic از زمان انتشار مقالهای از سوی مدیرعاملش، داریو آمودی، عرضه کرده؛ مقالهای که در آن از صنعت خواسته بود سرعت پیشرفت را کاهش دهد، با این استدلال که رشد قابلیتهای هوش مصنوعی از آزمونهای ایمنیای که قرار است آن را مهار کنند، جلو زده است. آمودی اوایل این ماه نوشت: «ما باید سرعتی را که با آن قابلیتهای مدلهای هوش مصنوعی را بهبود میدهیم، کاهش دهیم.»
Anthropic بخش عمده این پیشرفت را از طریق کدنویسی عاملی اندازهگیری میکند؛ یعنی کاری که توسط یک عامل هوش مصنوعی انجام میشود، مدلی که بهجای پاسخ دادن صرف به یک پرامپت واحد، بهطور مستقل اقدامات چندمرحلهای انجام میدهد.
در Terminal-Bench 4.0 که میسنجد آیا یک عامل میتواند وظایف حرفهای پیچیده را در محیط خط فرمان به پایان برساند و نتیجه را بهصورت درصد وظایف تکمیلشده امتیازدهی میکند، Opus 5.5 به ۶۶.۴٪ رسید؛ بالاتر از ۵۵.۸٪ برای Fable 5.1 و ۵۷.۹٪ برای GPT-6 Astra. همچنین FrontierCode که بررسی میکند آیا تغییرات کد یک عامل واقعاً در یک پایپلاین مهندسی واقعی ادغام میشود یا نه و از همین روش نرخ قبولی استفاده میکند، برای Opus 5.5 امتیاز ۵۴.۴٪ را ثبت کرد، در برابر ۵۰.۳٪ برای Fable 5.1.
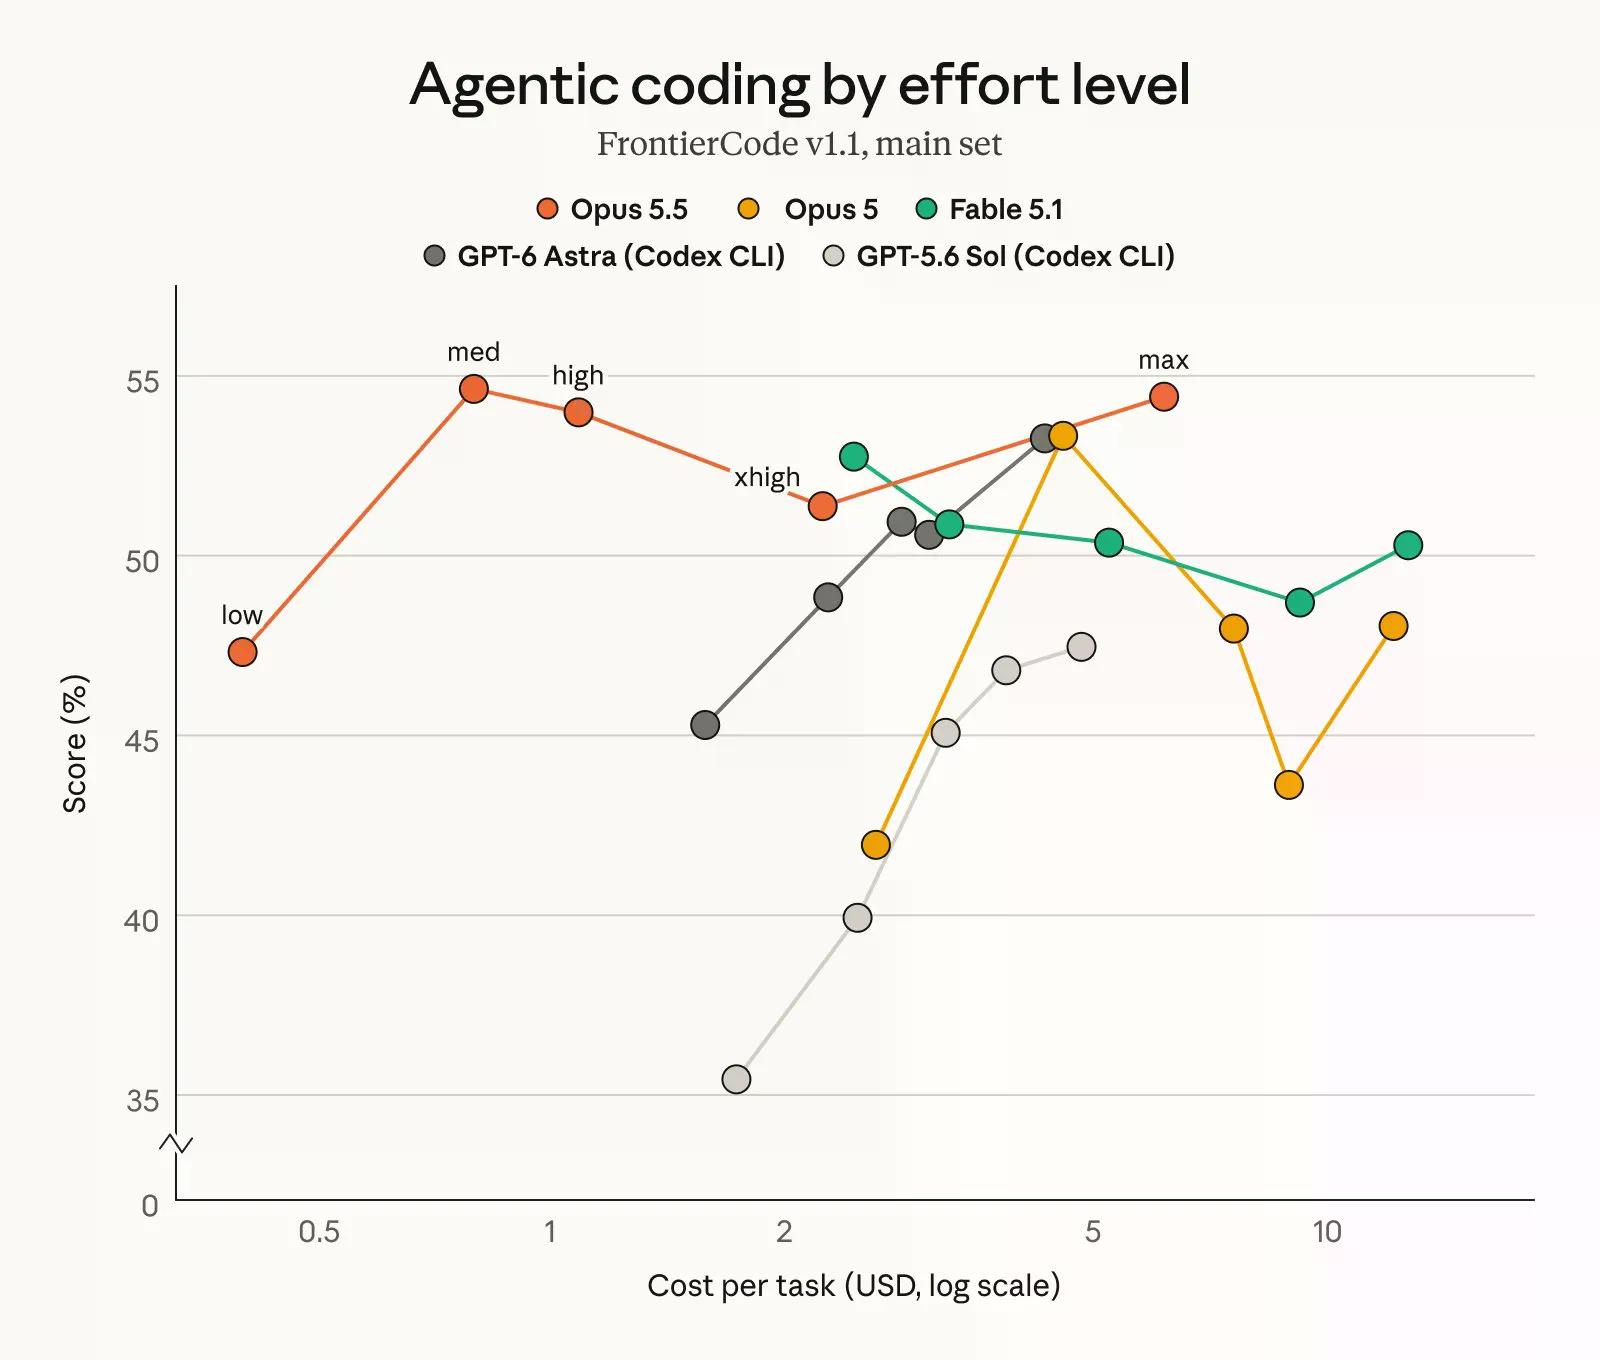
در GDPval-AA v2.1 که عملکرد حرفهای دنیای واقعی را در ۴۴ شغل با استفاده از Elo ارزیابی میکند؛ همان سیستم رتبهبندی شبیه شطرنج که برای سنجش مهارت نسبی بهجای درصد ثابت استفاده میشود؛ Opus 5.5 امتیاز ۱۸۴۶ را کسب کرد، در حالی که Fable 5.1 امتیاز ۱۷۳۵ و Opus 5 امتیاز ۱۷۰۸ را به دست آوردند.
با این حال، Opus 5.5 در همهجا پیشتاز نیست. در AutomationBench، بنچمارکی که Zapier ساخته و میسنجد آیا یک عامل میتواند یک گردشکار کامل کسبوکاری را از ابتدا تا انتها بدون کمک انسان انجام دهد یا نه، GPT-6 Astra با ۴۱.۴٪ اندکی بالاتر از Opus 5.5 با ۴۰.۰٪ قرار گرفت.
در Terminal-Bench-Science 0.1 نیز که پژوهش علمی عاملی انجامشده در محیط خط فرمان را با همین روش نرخ قبولی میسنجد، Astra با ۶۴.۶٪ و با اختلاف بیشتری Opus 5.5 را با ۵۸.۷٪ پشت سر گذاشت.
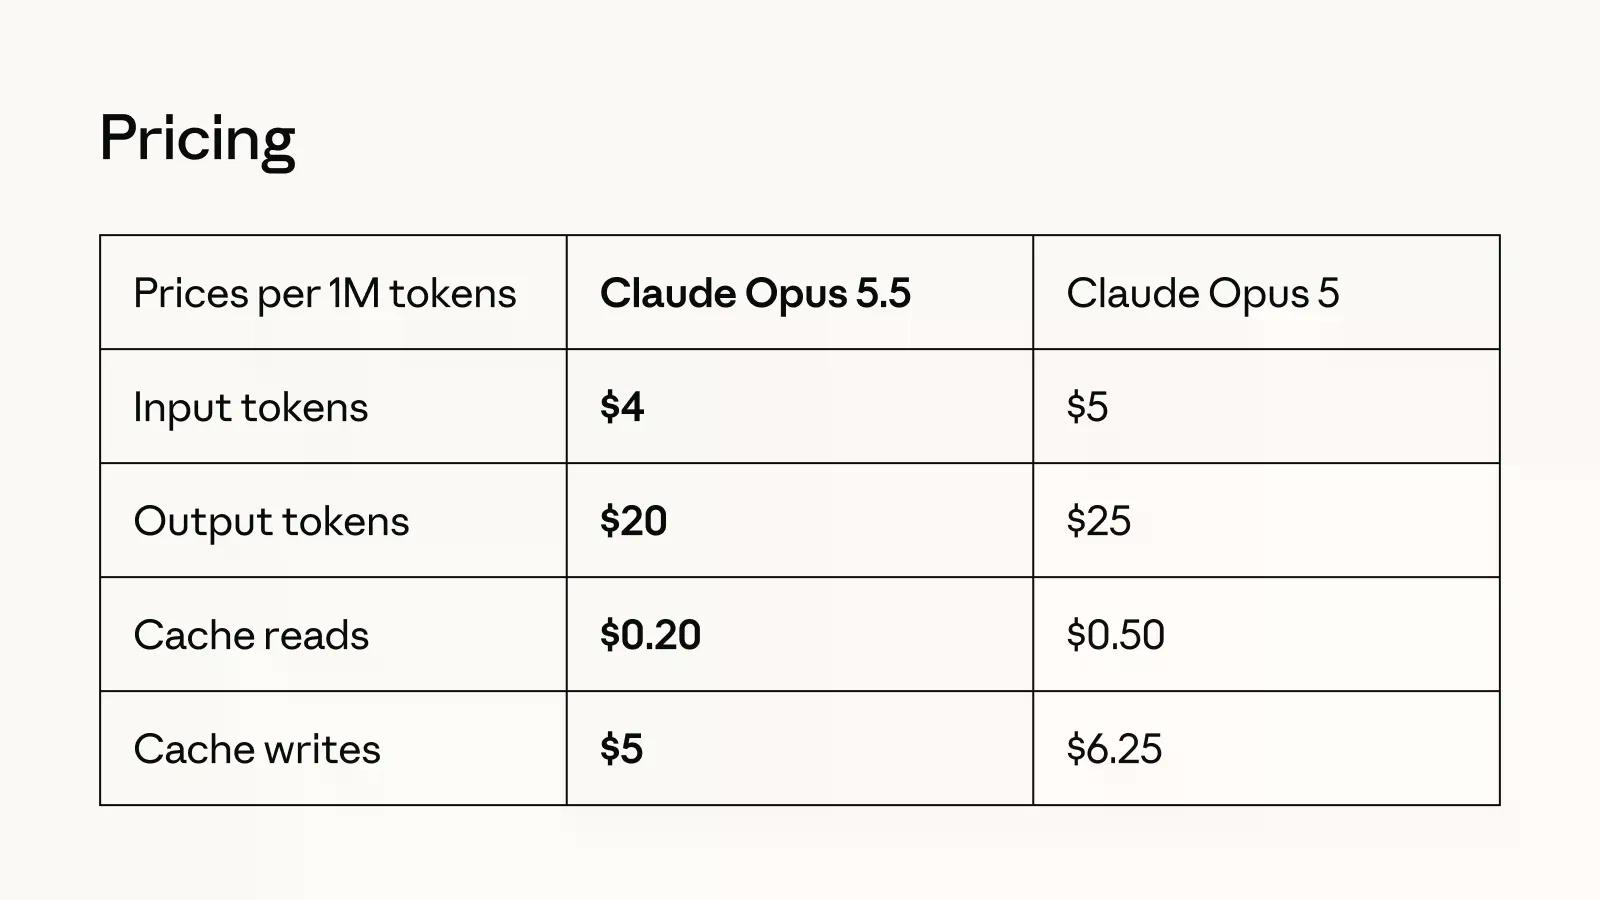
اما مزیت فروش مهمتر، هزینه است. توکنهای ورودی، یعنی بخشهای متنی که مدل میخواند و مینویسد و قیمتگذاری آنها به ازای هر یک میلیون توکن انجام میشود، اکنون برای Opus 5.5 برابر با ۴ دلار است در مقایسه با ۵ دلار برای Opus 5، و توکنهای خروجی از ۲۵ دلار به ۲۰ دلار کاهش یافتهاند. خوانشهای کش، که به معنای استفاده دوباره از کانتکستی است که مدل پیشتر پردازش کرده بهجای پردازش دوباره از صفر و عامل اصلی بخش عمده هزینه در سشنهای طولانی کدنویسی عاملی محسوب میشود، ۶۰٪ کاهش یافته و به ۰.۲۰ دلار به ازای هر یک میلیون توکن رسیده است.
از آنجا که Opus 5.5 در آن دو قابلیت با مدلهای کلاس Mythos شرکت Anthropic برابری میکند؛ محدودترین رده این شرکت که برای پژوهشگران تأییدشده امنیت سایبری و زیستشناسی رزرو شده است؛ این مدل با همان تدابیر حفاظتی Fable 5.1 عرضه میشود.
بیشتر وظایف امنیت سایبری بهصورت خودکار به مدل قدیمیتر Opus 4.8 ارجاع داده میشوند؛ موضوعی که بسیاری از توسعهدهندگان و کاربران پیشتر نسبت به آن گلایه کردهاند.
Opus 5.5 اکنون در سراسر پلتفرمهای Anthropic، از جمله Amazon Web Services، Google Cloud و Microsoft Azure، در دسترس است. Anthropic میگوید Sonnet 5.5 و Haiku 5.5 نیز در هفتههای آینده عرضه خواهند شد و همین کاهش قیمت را به سایر مدلهای این مجموعه تعمیم خواهند داد.








