


اوپنایآی روز سهشنبه دو مدل جدید به نامهای GPT-6 Sol و GPT-6 Luna را منتشر کرد. این اتفاق تنها چند دقیقه پس از آن رخ داد که Anthropic مدل Claude Opus 5.5، پرچمدار جدید خود، را معرفی کرد.
Sol و Luna پایینتر از GPT-6 Astra قرار میگیرند؛ مدلی که اوپنایآی هنگام عرضه آن در ۳ سپتامبر، از آن بهعنوان «باهوشترین و همراساترین مدل جهان» یاد کرد. Astra همچنان انتخاب اول اوپنایآی برای سختترین وظایف است؛ در حالی که Sol و Luna گزینههای ارزانتر و سریعتری هستند که برای کارهای روزمره ساخته شدهاند.
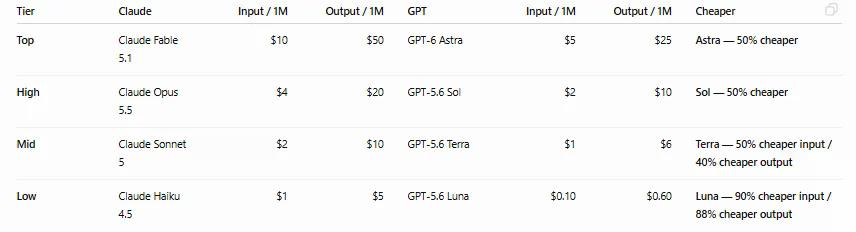
بنابراین این رویکرد بسیار شبیه همان استراتژیای است که Anthropic بهکار گرفته است. Astra معادل Fable است، Sol معادل Opus، Terra معادل Sonnet و Luna معادل Haiku (زمانی که ارتقا پیدا کند).
اوپنایآی همچنین برای حفظ رقابتپذیری، قیمتگذاری را بازتنظیم کرد. هزینه API هر دو مدل در مقایسه با نرخهای تبلیغاتی GPT-5.6 به ازای هر توکن، ۵۰٪ کاهش یافته است. توکنها همان واحدهای متنیای هستند که مدل میخواند و تولید میکند؛ معمولاً کمی کمتر از یک واژه کامل، و شرکتها هزینه را بر مبنای هر یک میلیون توکن پرداخت میکنند، چون صورتحسابهای هوش مصنوعی در مقیاس بالا به همین شکل تجمیع میشود.
لطفاً به GPT-6 Sol و GPT-6 Luna در جهان GPT-6 خوشآمد بگویید.
GPT-6 Sol و Luna بر پایه پیشرفتهای پشت GPT-6 Astra ساخته شدهاند و بخش زیادی از نقاط قوت آن را در قالب مدلهایی سریعتر و مقرونبهصرفهتر برای پشتیبانی از کار در مقیاس بالا ارائه میکنند.
ما همچنین کشینگ و استنتاج را کارآمدتر کردهایم، و… pic.twitter.com/5LiVE4rbFt
— OpenAI (@OpenAI) ۲۲ سپتامبر ۲۰۲۶
قیمت Sol اکنون ۲ دلار به ازای هر یک میلیون توکن ورودی و ۱۰ دلار به ازای هر یک میلیون توکن خروجی است؛ در حالی که پیشتر این ارقام ۴ دلار و ۲۰ دلار بودند. قیمت Luna نیز به ۰.۱۰ دلار و ۰.۵۰ دلار کاهش یافته، در حالی که قبلاً ۰.۲۰ دلار و ۱.۲۰ دلار بود. در مجموع، اوپنایآی در مقایسه با Anthropic در هر لایه قیمتی، پیشنهاد ارزانتری ارائه میدهد.
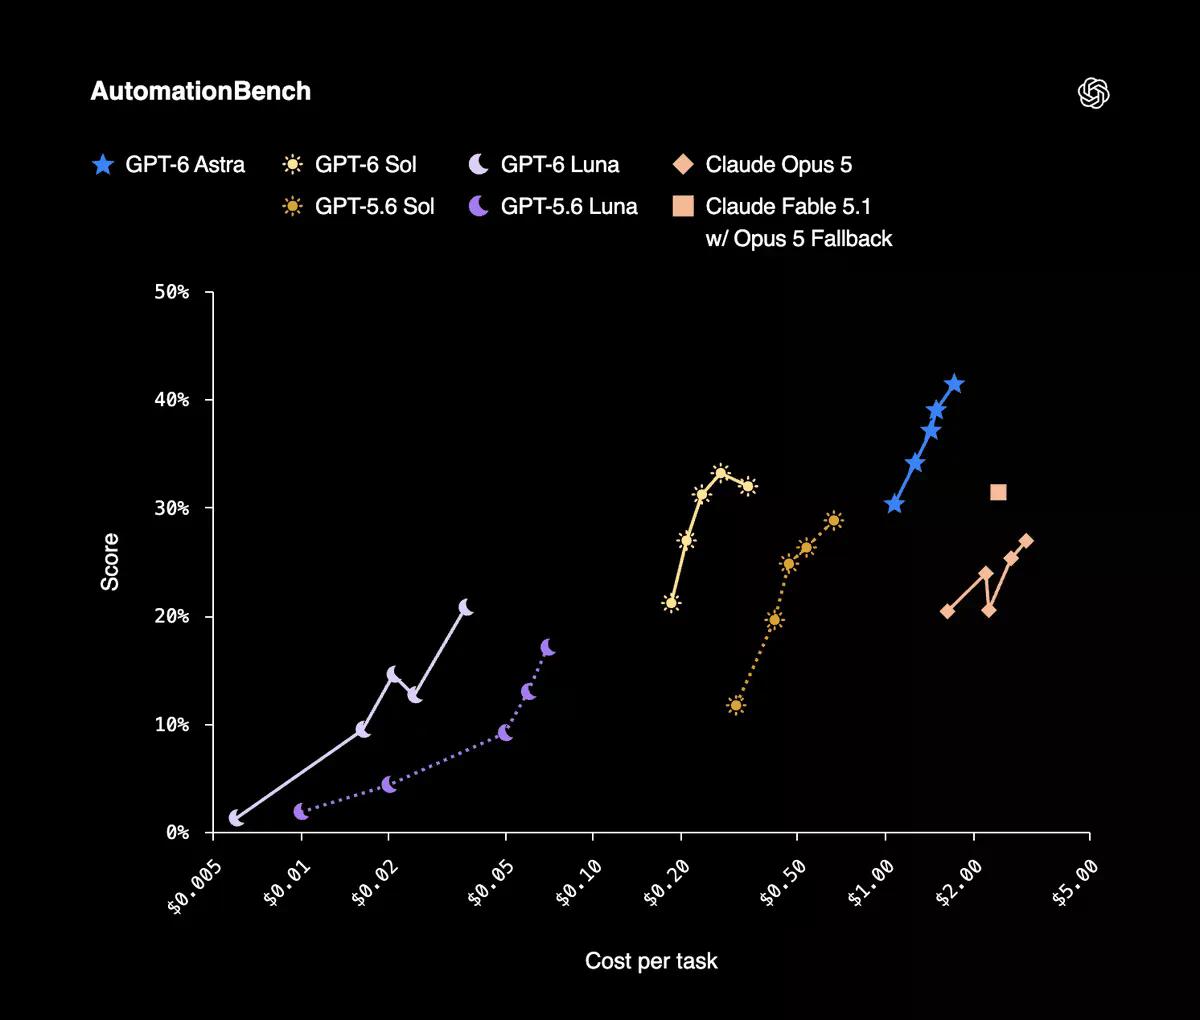
استدلال مربوط به عملکرد بر AutomationBench تکیه دارد؛ یک بنچمارک ساختهشده توسط Zapier که بررسی میکند آیا یک ایجنت هوش مصنوعی میتواند با استفاده از ۴۷ ابزار در حوزههای فروش، بازاریابی، عملیات، پشتیبانی، مالی و منابع انسانی، یک جریان کاری کامل کسبوکار را اجرا کند یا نه. امتیازدهی آن بر اساس نرخ قبولی انجام میشود. GPT-6 Sol در بالاترین تنظیم استدلال خود، امتیاز ۳۳.۲٪ را با هزینه ۰.۲۷ دلار برای هر وظیفه ثبت کرد.
Claude Opus 5 در بالاترین تنظیم خود امتیاز ۲۶.۹٪ را کسب کرد، اما طبق ارقام خود اوپنایآی، هزینه هر وظیفه در آن بیش از ۱۱ برابر بیشتر بود. GPT-6 Sol همچنین در همین آزمون، Claude Fable 5.1، پرچمدار گرانتر Anthropic، را نیز با اختلافی اندک پشت سر گذاشت.
در آزمون Agents' Last Exam که ایجنتهای هوش مصنوعی را در کارهای طولانی و دارای ارزش اقتصادی در ۵۵ زیرصنعت ارزیابی میکند و نتایج را بر پایه درصد تکمیلشده نمره میدهد، GPT-6 Sol در بالاترین سطح تلاش خود امتیاز ۵۶.۴٪ بهدست آورد. اوپنایآی میگوید این نتیجه، بهترین امتیاز Claude Opus 5 را با هزینهای ۶۰٪ کمتر به ازای هر وظیفه پشت سر میگذارد.
«تلاش استدلالی» یک تنظیم جدید است که اوپنایآی اضافه کرده است: با افزایش آن، مدل پیش از پاسخ دادن زمان و توان محاسباتی بیشتری صرف بازبینی دوباره خود میکند؛ موضوعی که معمولاً دقت و هزینه را همزمان بالا میبرد.
برای استفاده رایانهای—یعنی زمانی که یک ایجنت هوش مصنوعی مانند انسان روی نرمافزار کلیک میکند، تایپ میکند و در محیط برنامهها جابهجا میشود—GPT-6 Sol در OSWorld 2.0 تقریباً با امتیاز Claude Opus 5 در سطح تلاش متوسط برابر بود: ۶۰.۵٪ در برابر ۶۰.۳٪، آن هم با حدود ۸۰٪ هزینه کمتر. OSWorld وظایف طولانی و واقعگرایانه رایانهای را آزمایش میکند و بر اساس میزان انجام صحیح کار، یک امتیاز جزئی گزارش میدهد.
GPT-6 Sol و Luna اکنون در ChatGPT Work و Codex برای مشترکان Plus، Pro، Business، Enterprise و Edu فعال شدهاند و Luna همچنین از طریق اپلیکیشن دسکتاپ به کاربران رایگان و Go نیز رسیده است.
هیچیک از این دو مدل هنوز در نسخه عادی اپ ChatGPT در دسترس نیستند و اوپنایآی میگوید برای حفظ پایداری سرویس، هر دو را بهتدریج در طول روز عرضه میکند.








